
싱글벙글 챗지피티 잠수함 패치
가 진짜 있었다는 사실을 증명하는 스탠퍼드, UC 버클리 논문
GPT-4를 기준으로
출시 초기였던 3월에는 수학 문제 정확도가 97.2%, 6월에는 3% 이하였음
출시 초기였던 3월에는 첫 시도에 완벽하게 동작하는 코드의 비율이 50%, 6월에는 10% 미만
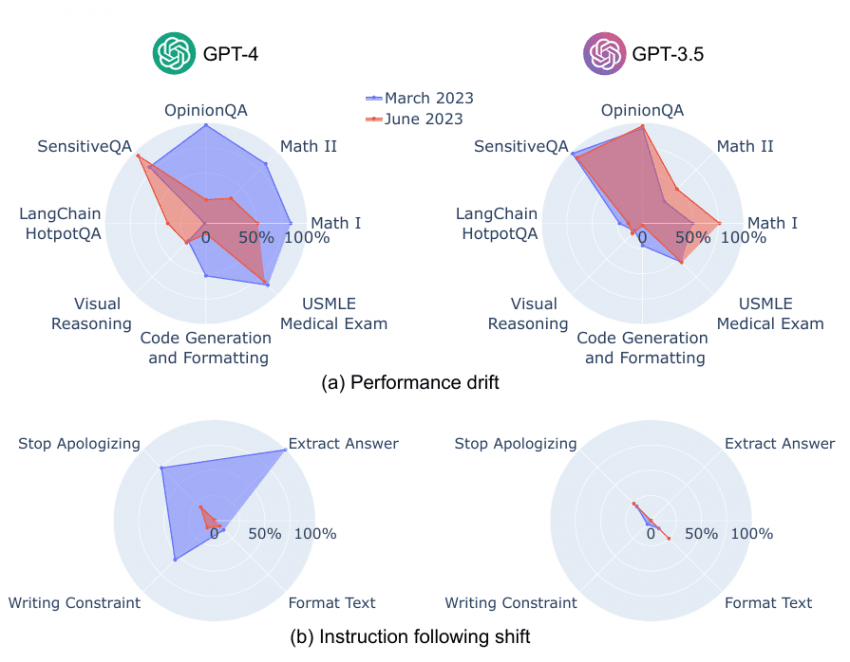
USMLE 의학 시험(의사들이 탈조선할때 보는 그 시험 ㅎ) 능력은 3월이나 6월이나 큰 차이 없었고
여러단계 생각을 해야 하는 질문이나 민감한 질문에 대처하는 능력(탈옥 방지)은 늘었지만
수학 / 코딩 / 의견을 묻는 질문에 대한 능력은 바닥으로 내려감
다들 뻔히 알고는 있었지만 굳이 말로 꺼내면 꼭 득달같이 달려와서 ‘기분탓 아니냐, 잘못쓴거다’ 등등 별 소리를 다 들었는데
논문으로 증명된 바 적어도 GPT-4는 서비스하면서 계속 꾸준히 잠수함 패치가 있어왔다
그리고 아마 챗지피티는 물론이고 다른 서빙 회사들도 똑같은 잠수함 패치를 꾸준히 할 것이라는 얘기
출시 초기엔 똑똑해보였던 언어모델이 꼭 다음 모델 나올때쯤 되면 개병신이 되는걸로 느껴졌다면 착각이 아님
출처: 싱글벙글 지구촌 갤러리 [원본 보기]


댓글0